Le score qui mentait
Inventorier 496 livres avec une IA locale : les premiers chiffres disaient 93 %, la bibliothèque disait non. Ce que deux erreurs de mesure m'ont appris sur la confiance.
J’ai inventorié ma bibliothèque avec une IA qui tourne sur mon portable. Les premiers chiffres disaient 93 %, les étagères disaient non. Ce texte raconte deux erreurs de mesure, et ce qu’elles m’ont appris sur la confiance qu’on peut accorder à une IA, chez soi comme en entreprise.
Quatre photos et un portable
J’ai beaucoup de livres. Je venais de réinstaller toute ma bibliothèque, un peu en désordre, je n’avais pas la liste complète, et pour retrouver un livre là-dedans c’était compliqué. J’ai essayé une photo dans un service en ligne : il me sortait à peu près la liste des bouquins. C’était donc faisable. Comme je savais qu’il faudrait rescanner régulièrement, pour ne pas payer à chaque fois les jetons, l’unité de facturation des IA en ligne, et aussi par défi, j’ai décidé d’essayer en local, sur mon portable, avec un modèle d’IA capable de lire des images, qui tourne sur sa carte graphique de 8 Go.
Le principe est simple. Chaque photo est découpée en tuiles, chaque tuile est lue par le modèle, les listes sont fusionnées et dédoublonnées. Pour savoir si cela marche, j’ai fait ce qu’on fait toujours en ingénierie : une vérité terrain, deux étagères lues à la main au zoom, et un scoreur qui compare ce que le modèle a lu à ce qui est vraiment sur la planche. Les premières campagnes affichaient 92 à 93 % de rappel, c’est-à-dire la part des livres réellement présents que le modèle retrouve. J’ai choisi un modèle sur cette base, et j’ai commencé à comparer des formulations de consigne.
Le chiffre disait 93, la bibliothèque disait non
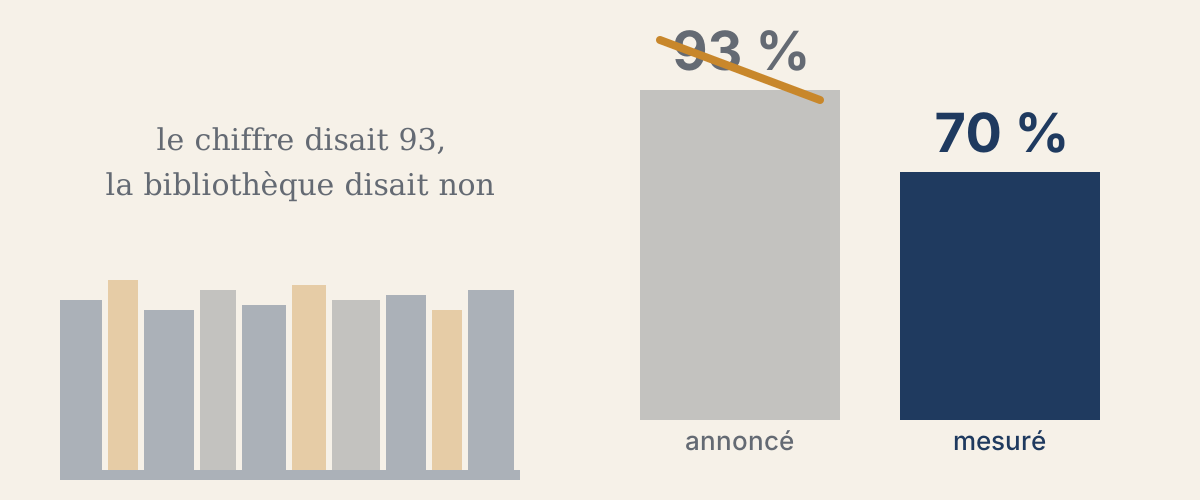
Puis j’ai regardé la liste. Il y avait des livres que je n’avais pas, et des livres que j’avais et que je ne retrouvais pas. Je suis allé voir aux endroits indiqués dans la bibliothèque : ce n’étaient pas les bons livres. J’étais déçu. Le chiffre disait 93, la bibliothèque disait non. En remontant, nous avons trouvé le défaut : le scoreur, écrit avec l’IA comme tout le reste du projet, acceptait l’inclusion de chaînes d’un seul caractère. Une lecture « David Copperfield | I » validait n’importe quel titre contenant un « i », « Kafka sur le rivage » par exemple. Recalculées honnêtement, les campagnes tombaient entre 68 et 71 %. Et la variance que je croyais voir entre deux passes n’existait pas : le modèle répond toujours la même chose à la même photo, c’est le scoreur qui avait changé entre-temps.
Ce qui m’avait rendu confiant trop vite, je le sais. J’avais derrière moi des tests réussis sur des notes de frais et des factures, avec les mêmes modèles. Alors je me suis mis à douter de tout : la consigne, le modèle ? Nous sommes repartis sur un banc comparatif de plusieurs modèles, et j’ai découvert au passage que le classement que je croyais acquis ne tenait qu’à une tuile et à une formulation. Comme les modèles sortent vite, j’ai décidé de refaire des bancs régulièrement, pour voir ce qui marche mieux et si cela s’est amélioré.
Dix jours plus tard, un second défaut
À l’audit du projet, un second défaut de mesure. Le scoreur comptait « au moins une correspondance » au lieu d’apparier chaque livre attendu à une seule lecture : une lecture validait les deux volumes d’un même roman, et un dos lu deux fois comptait deux fois en précision, la part des livres lus qui sont vraiment sur l’étagère. Les 95 % de la configuration retenue sont redescendus à 91 %. Cette fois aucun classement ne s’est inversé, mais la leçon est là : cela arrive deux fois, même en faisant attention. Quand on utilise une IA, elle est souvent très affirmative, très sûre d’elle, et on a tendance à suivre ses préconisations. Le test vis-à-vis du réel nous remet sur les rails, et nous rappelle de faire plus attention.
Ce que j’en ai tiré
Deux règles, d’abord. Toujours recalculer les scores avant de comparer deux campagnes, et ne jamais comparer un chiffre ancien à un chiffre nouveau. Garder les listes produites, pas seulement les pourcentages, pour pouvoir recalculer. Et trois gestes que je fais maintenant sur tous mes projets.
- Faire relire une IA par une autre, quand mes moyens le permettent. C’est facile sur les modèles locaux, moins sur les plus gros.
- Échantillonner à la main. Je vérifie que le pourcentage affiché est cohérent avec ce que je vois quand je prends dix cas au hasard.
- Automatiser la mesure quand c’est possible : des bancs et des tests qui tournent à chaque changement.
Le résultat aujourd’hui
496 livres inventoriés sur quatre photos, 493 situés au dos près, douze genres, 91 % de rappel et 93 % de précision mesurés honnêtement sur 57 livres annotés, et un petit site de consultation sur le réseau de la maison. Trois décisions ont pesé : découper en tuiles zoomées, qui a fait passer le rappel de 71 à 93 % ; désactiver le mode où le modèle raisonne longuement avant de répondre, qui épuisait la longueur de réponse autorisée ; et mesurer honnêtement. On s’en sert régulièrement. Il reste de petits défauts, mais la valeur apportée est bien plus grande que ces défauts.
Ce que je dirais à un dirigeant
À un dirigeant à qui l’on présente une démonstration à 95 % de précision sur ses documents, je dirais que c’est la même démarche qu’avec n’importe quel nouveau prestataire. Les premières fois, il faut un peu de temps pour établir la confiance : on éprouve les premiers rendus, et si cela ne fonctionne pas, on clarifie les règles et les attendus, on rediscute ce qu’on cherche à faire. Il ne faut pas avoir une foi aveugle dans ce que donne une IA, il faut la prendre comme un outil qui se trompe. Et demander deux choses avant de signer : qui a annoté la vérité terrain qui donne ce 95 %, et ce que cela donne sur vos documents à vous.
La question que je me pose encore
C’est toujours la même : jusqu’à quel point c’est fiable. Je me pose peu la question de la mauvaise foi d’une IA, peut-être à tort. Mais la mauvaise interprétation, l’hallucination, la consigne mal comprise, et ces consignes qu’on finit par rendre compliquées et qu’on ne relit plus : la chaîne devient complexe, avec plein de points où elle peut se mettre en défaut. Je doute donc toujours un peu de la réponse, et c’est sans doute ce doute qui fait que l’outil marche.
Ce qu’un dirigeant en retient. Un pourcentage de démonstration n’est pas une mesure. Demandez qui a annoté la vérité terrain, testez sur vos propres documents, et traitez l’IA comme un nouveau prestataire : la confiance se construit sur les rendus, pas sur l’annonce.